
Tien minuten om een satelliet te lezen
Een satelliet is maar even in contact met de aarde. Valt dan een server uit, dan bevriest het scherm van de ingenieur, ook al is er niets mis met de satelliet. Bij Redwire bouwde ik een systeem dat de storing zelf herkent en overschakelt, zonder dat iemand hoeft te klikken.
Door Jelle Smet · Applied Data Intelligence, Thomas More Mechelen
Tien minuten, dan is hij weg
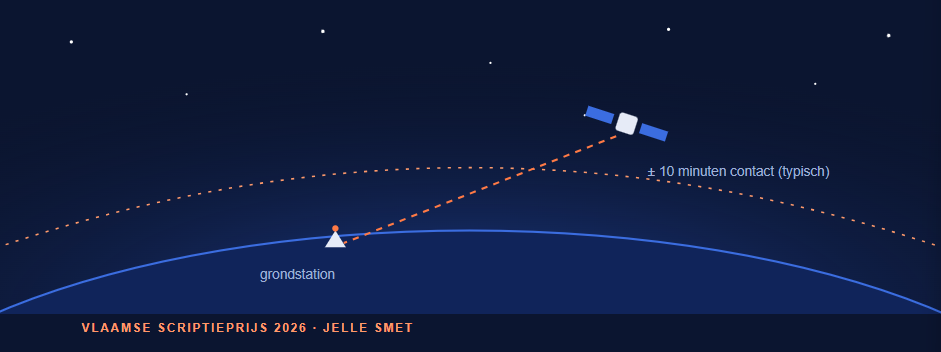
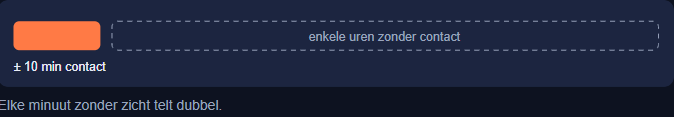
Een satelliet hangt niet de hele dag boven je hoofd. Het contactvenster met een grondstation duurt typisch zo’n tien minuten. De volgende kans komt vaak pas na uren.
In die minuten stroomt de telemetrie binnen, de hartslag van het ruimtetuig: batterijspanning, temperatuur, de stand van de zonnepanelen. Ingenieurs lezen die af op grafieken.
Stel je de controlekamer voor. De satelliet raast boven je door en je volgt een batterijspanning die langzaam zakt. Dan bevriest de grafiek.
Er is niets mis met de satelliet. Een server op aarde is uitgevallen. Jij ziet niets meer terwijl het venster wegtikt.
Wachten op één grafiek
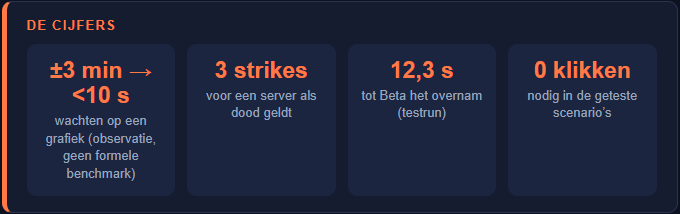
Redwire, het ruimtevaartbedrijf in Kruibeke, gebruikte voor eerdere missies een gespecialiseerde, betrouwbare visualisatie-infrastructuur. Ingenieurs merkten bij sommige visualisaties wel een wachttijd van ongeveer drie minuten. Of dat aanvaardbaar is, hangt af van het missieprofiel. Bij satellieten in een lage baan, met hun korte zichtvenster, telt elke minuut zwaarder. Dat is een operationele observatie, geen formele benchmark.
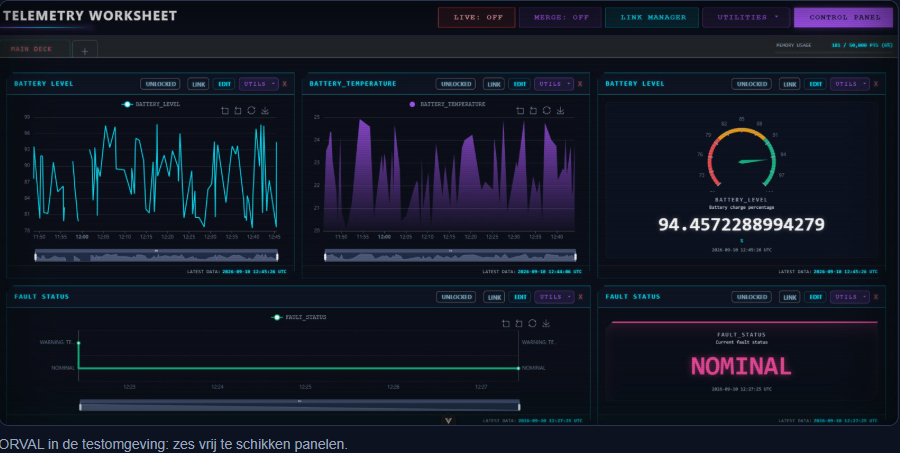
Tijdens mijn stage kreeg ik de opdracht een alternatief te bouwen dat veel sneller visualiseert. Ik ontwikkelde ORVAL zelf, in overleg met de ingenieurs die het zouden gebruiken. Het toont telemetrie op dashboards die de ingenieur zelf samenstelt. Lange periodes vat de database vooraf samen, zodat de browser niet bezwijkt onder miljoenen punten. Een typische opvraging staat binnen tien seconden op het scherm.
De scheidsrechter die zijn fluitje inhoudt
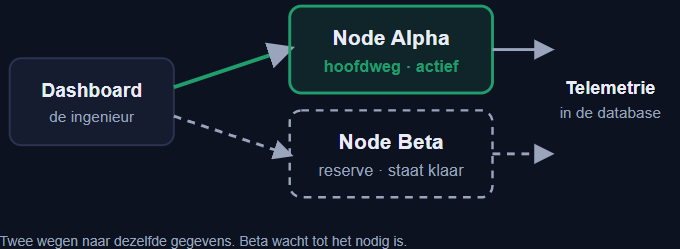
Alles hangt af van de server achter het scherm. Daarom draait ORVAL op twee: Alpha als hoofdserver en Beta als reserve. Beide bereiken dezelfde telemetrie in de database. Maar een reserve alleen volstaat niet.
Netwerken kunnen hikken. Schakelt het systeem bij elke haperende halve seconde over, dan volgt vals alarm op vals alarm. Een trage maar gezonde server, bijvoorbeeld bij een zware opvraging, mag evenmin als onbereikbaar gezien worden.
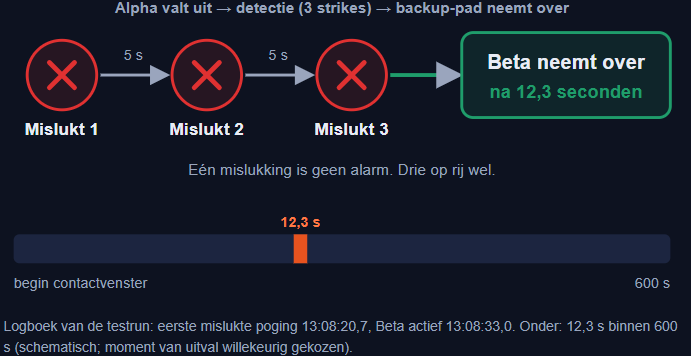
Daarom bedacht ik de 3-strikeregel. Denk aan een scheidsrechter die een lichte fout laat gaan en pas bij de derde een kaart trekt. Eén mislukte poging kan toeval zijn; drie op rij is bewijs. Mislukt een gegevensopvraging, dan probeert ORVAL het tot drie keer toe, telkens met vijf seconden wachttijd en vijf seconden pauze ertussen. Pas na de derde mislukking beschouwt het server Alpha als onbereikbaar en schakelt het over. Dat kost tien tot vijfentwintig seconden: de tijd die je koopt om zeker te zijn.
Er zit geen gokwerk in. Dezelfde storing leidt altijd tot dezelfde reactie, volgens vaste regels. Dat heet deterministisch en het maakt het systeem voorspelbaar en reproduceerbaar wanneer seconden tellen.
De omschakeling in 12,3 seconden
Dan gaat het snel. ORVAL stuurt al het verkeer naar server Beta. In de geteste scenario’s hoefde niemand te klikken, te herladen of opnieuw in te loggen.
In een volledig gemeten testrun op Redwire-hardware duurde het 12,3 seconden van de eerste mislukte poging tot de bevestiging dat server Beta het overnam. Dat is ongeveer twee procent van een typisch contactvenster. Zo’n twintig herhalingen gaven hooguit één seconde verschil. Eerlijk is eerlijk: tijdens die seconden krijgen de live-grafieken geen nieuwe punten. Maar niemand moest de storing opmerken, begrijpen en oplossen terwijl het venster wegtikte.
De cijfers
Wat de ingenieurs zeggen
Thuiskomen zonder omkijken
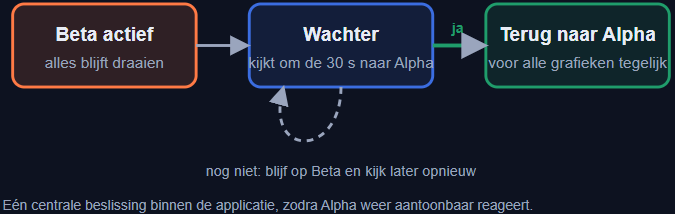
Terugkeren blijkt lastiger dan vluchten. Elke grafiek vraagt zelf data op. Beslist elke grafiek apart wanneer het genoeg is, dan zit de ene gebruiker bij server Beta terwijl de andere bij Alpha blijft hangen. Twee collega’s zien dan een andere werkelijkheid.
Daarom neemt ORVAL binnen de applicatie één centrale routeringsbeslissing. Zolang Beta actief is, controleert een wachter elke dertig seconden of Alpha weer reageert. Zodra dat zo is, schakelt de applicatie voor alle grafieken tegelijk terug. Sessies en dashboards blijven intact, zonder herladen of nieuwe login.
Wat al bewezen is
Aangetoond is een automatische omschakeling in testruns op Redwire-hardware. Het ontwerp mikt ook op live missies en op 25 tot 30 gelijktijdige gebruikers, maar dat is nog niet in de praktijk bewezen.
Het principe reikt mogelijk verder. De foutbestendigheid zit in het ontwerp, niet in de databron. In theorie past dezelfde aanpak op andere gestructureerde bedrijfsdata waar stilstand pijn doet. Getest is dat niet.
De satelliet merkt hier niets van. Hij blijft zijn hele contactvenster lang gegevens sturen. Mijn taak was ervoor te zorgen dat de ingenieur ze blijft zien. In de ruimtevaart mag de reactietijd van een mens nooit het enige vangnet zijn. Een goed systeem schakelt zelf over, precies op het moment dat het ertoe doet.
Bibliografie
Al-Sayed, M. (2022). High-availability clusters: A taxonomy, survey, and future directions. Journal of Systems and Software, 187, 111208. Retrieved from https://www.sciencedirect.com/science/article/abs/pii/S0164121221002806
Amazon Web Services (AWS). (2026). Active-active and active-passive failover. Retrieved from Amazon Web Services: https://docs.aws.amazon.com/Route53/latest/DeveloperGuide/dns-failover-…
Avizienis, A., Laprie, J.-C., Randell, B., & Landwehr, C. (2004). Basic concepts and taxonomy of dependable and secure computing. IEEE Transactions on Dependable and Secure Computing, 1, 11 - 33. doi:10.1109/TDSC.2004.2
Baumgartner, A., Martínez-Heras, J., Donati, A., & Quintana, M. (2005). MUST – A Platform for Introducing Innovative Technologies in Operations. Proceedings of the 8th International Symposium on Artificial Intelligence, Robotics and Automation for Space (i-SAIRAS 2005). Munich. Retrieved from https://www.researchgate.net/publication/228661784_MUST-A_Platform_for_…
Chandra, T., & Toueg, S. (1996). Unreliable failure detectors for reliable distributed systems. Journal of the ACM, 43, 225-267. doi:10.1145/226643.226647
Cisco Systems. (2007). Network Management: Implementing and Operating High Availability Solutions. Retrieved from Cisco Systems: https://www.cisco.com/en/US/technologies/tk869/tk769/white_paper_c11-44…
ECSS. (2016). Space engineering: Ground systems and operations — Telemetry and telecommand packet utilization (ECSS-E-ST-70-41C). European Cooperation for Space Standardization.
European Cooperation for Space Standardization (ECSS). (2016). ECSS-E-ST-70-41C: Telemetry and telecommand packet utilization. ECSS Secretariat / ESA-ESTEC.
European Space Agency (ESA). (2007). Recovery from Unexpected Events. Retrieved from https://www.esa.int/esapub/br/br265/br265.pdf
European Space Agency (ESA). (2016). Space-to-Ground Data Viewer. Living Planet Symposium. European Space Agency.
European Space Agency (ESA). (2024). Mission Utility and Support Tools (MUST). Retrieved from ESA: https://www.esa.int/Enabling_Support/Space_Engineering_Technology/Missi…
European Space Agency (ESA). (2024). Routine operations. Retrieved from European Space Agency: https://www.esa.int/About_Us/ESOC/Routine_operations
European Space Agency (ESA). (2026). Method and apparatus for analysing time series data. Retrieved from ESA: https://www.esa.int/Enabling_Support/Space_Engineering_Technology/Metho…
Fortescue, P. W., Swinerd, G. G., & Stark, J. P. (2011). Spacecraft Systems Engineering (4th ed.). Chichester: John Wiley & Sons.
HAProxy Technologies. (2026). Configure two HAProxy Enterprise servers for active/standby clustering. Retrieved from HAProxy Technologies: https://www.haproxy.com/documentation/haproxy-enterprise/administration…
HAProxy Technologies. (2026). Failover. Retrieved from HAProxy Technologies: https://www.haproxy.com/glossary/what-is-failover
HAProxy Technologies. (2026). Health checks. Retrieved from HAProxy Technologies: https://www.haproxy.com/documentation/haproxy-configuration-tutorials/r…
Istio Authors. (2026). Traffic Management. Retrieved from Istio Documentation: https://istio.io/latest/docs/concepts/traffic-management/
Kubernetes Authors. (2026). Kubernetes Self-Healing. Retrieved from Kubernetes Documentation: https://kubernetes.io/docs/concepts/architecture/self-healing/
Kubernetes Authors. (2026). Liveness, Readiness, and Startup Probes. Retrieved from Kubernetes Documentation: https://kubernetes.io/docs/concepts/workloads/pods/probes/
Microsoft Corporation. (2025). Redundancy, replication, and backup. Retrieved from Microsoft Learn: https://learn.microsoft.com/en-us/azure/reliability/concept-redundancy-…
NASA. (2024). Basics of Space Flight: Telemetry, Tracking and Command. Retrieved from https://science.nasa.gov/learn/basics-of-space-flight/
NASA. (2024). Ground Data Systems and Mission Operations. Retrieved from NASA Science: https://www.nasa.gov/smallsat-institute/sst-soa/ground-data-systems-and…
National Aeronautics and Space Administration (NASA). (2026). Open Mission Control Technologies (Open MCT). Retrieved from NASA Science: https://ammos.nasa.gov/openmct/
National Institute of Standards and Technology (NIST). (2026). Fault Tolerance — CSRC Glossary. Retrieved from Computer Security Resource Center (CSRC), NIST: https://csrc.nist.gov/glossary/term/fault_tolerance
National Institute of Standards and Technology (NIST). (2026a). Availability — CSRC Glossary. Retrieved from Computer Security Resource Center (CSRC), NIST: https://csrc.nist.gov/glossary/term/availability
National Institute of Standards and Technology (NIST). (2026b). High Availability — CSRC Glossary. Retrieved from Computer Security Resource Center (CSRC), NIST: https://csrc.nist.gov/glossary/term/high_availability
Német, A. (2023). OXI: An online tool for visualization and annotation of satellite time series data. SoftwareX, 23, 101476. Retrieved from https://www.sciencedirect.com/science/article/pii/S2352711023001723
Oracle Corporation. (2026). High Availability. Retrieved from Oracle: https://docs.oracle.com/en-us/iaas/Content/cloud-adoption-framework/hig…
Prakash, A. (2022). Data-driven mixed-integer linear programming-based optimisation for efficient failure detection in large-scale distributed systems. European Journal of Operational Research. Retrieved from https://www.sciencedirect.com/science/article/abs/pii/S0377221722000947
Solenix. (2026). MUST: Mission Utility and Support Tools. Retrieved from Solenix (or Solenix — MUST): https://www.solenix.com/products/must
Tanenbaum, A. S., & Van Steen, M. (2017). Distributed Systems: Principles and Paradigms (3rd ed.). CreateSpace Independent Publishing Platform.